一、同样的租金,采购价不同,账就不同
SMM在2026年9—10月采集的渠道报价显示,昇腾910B4八卡整机全新报价为96万元,单卡64GB。同类资源的租赁报价分成三档:64台批量为1.55万元/台·月,一年、三年租期同价;5—16台小批为1.90万元;零售为2.20万元。
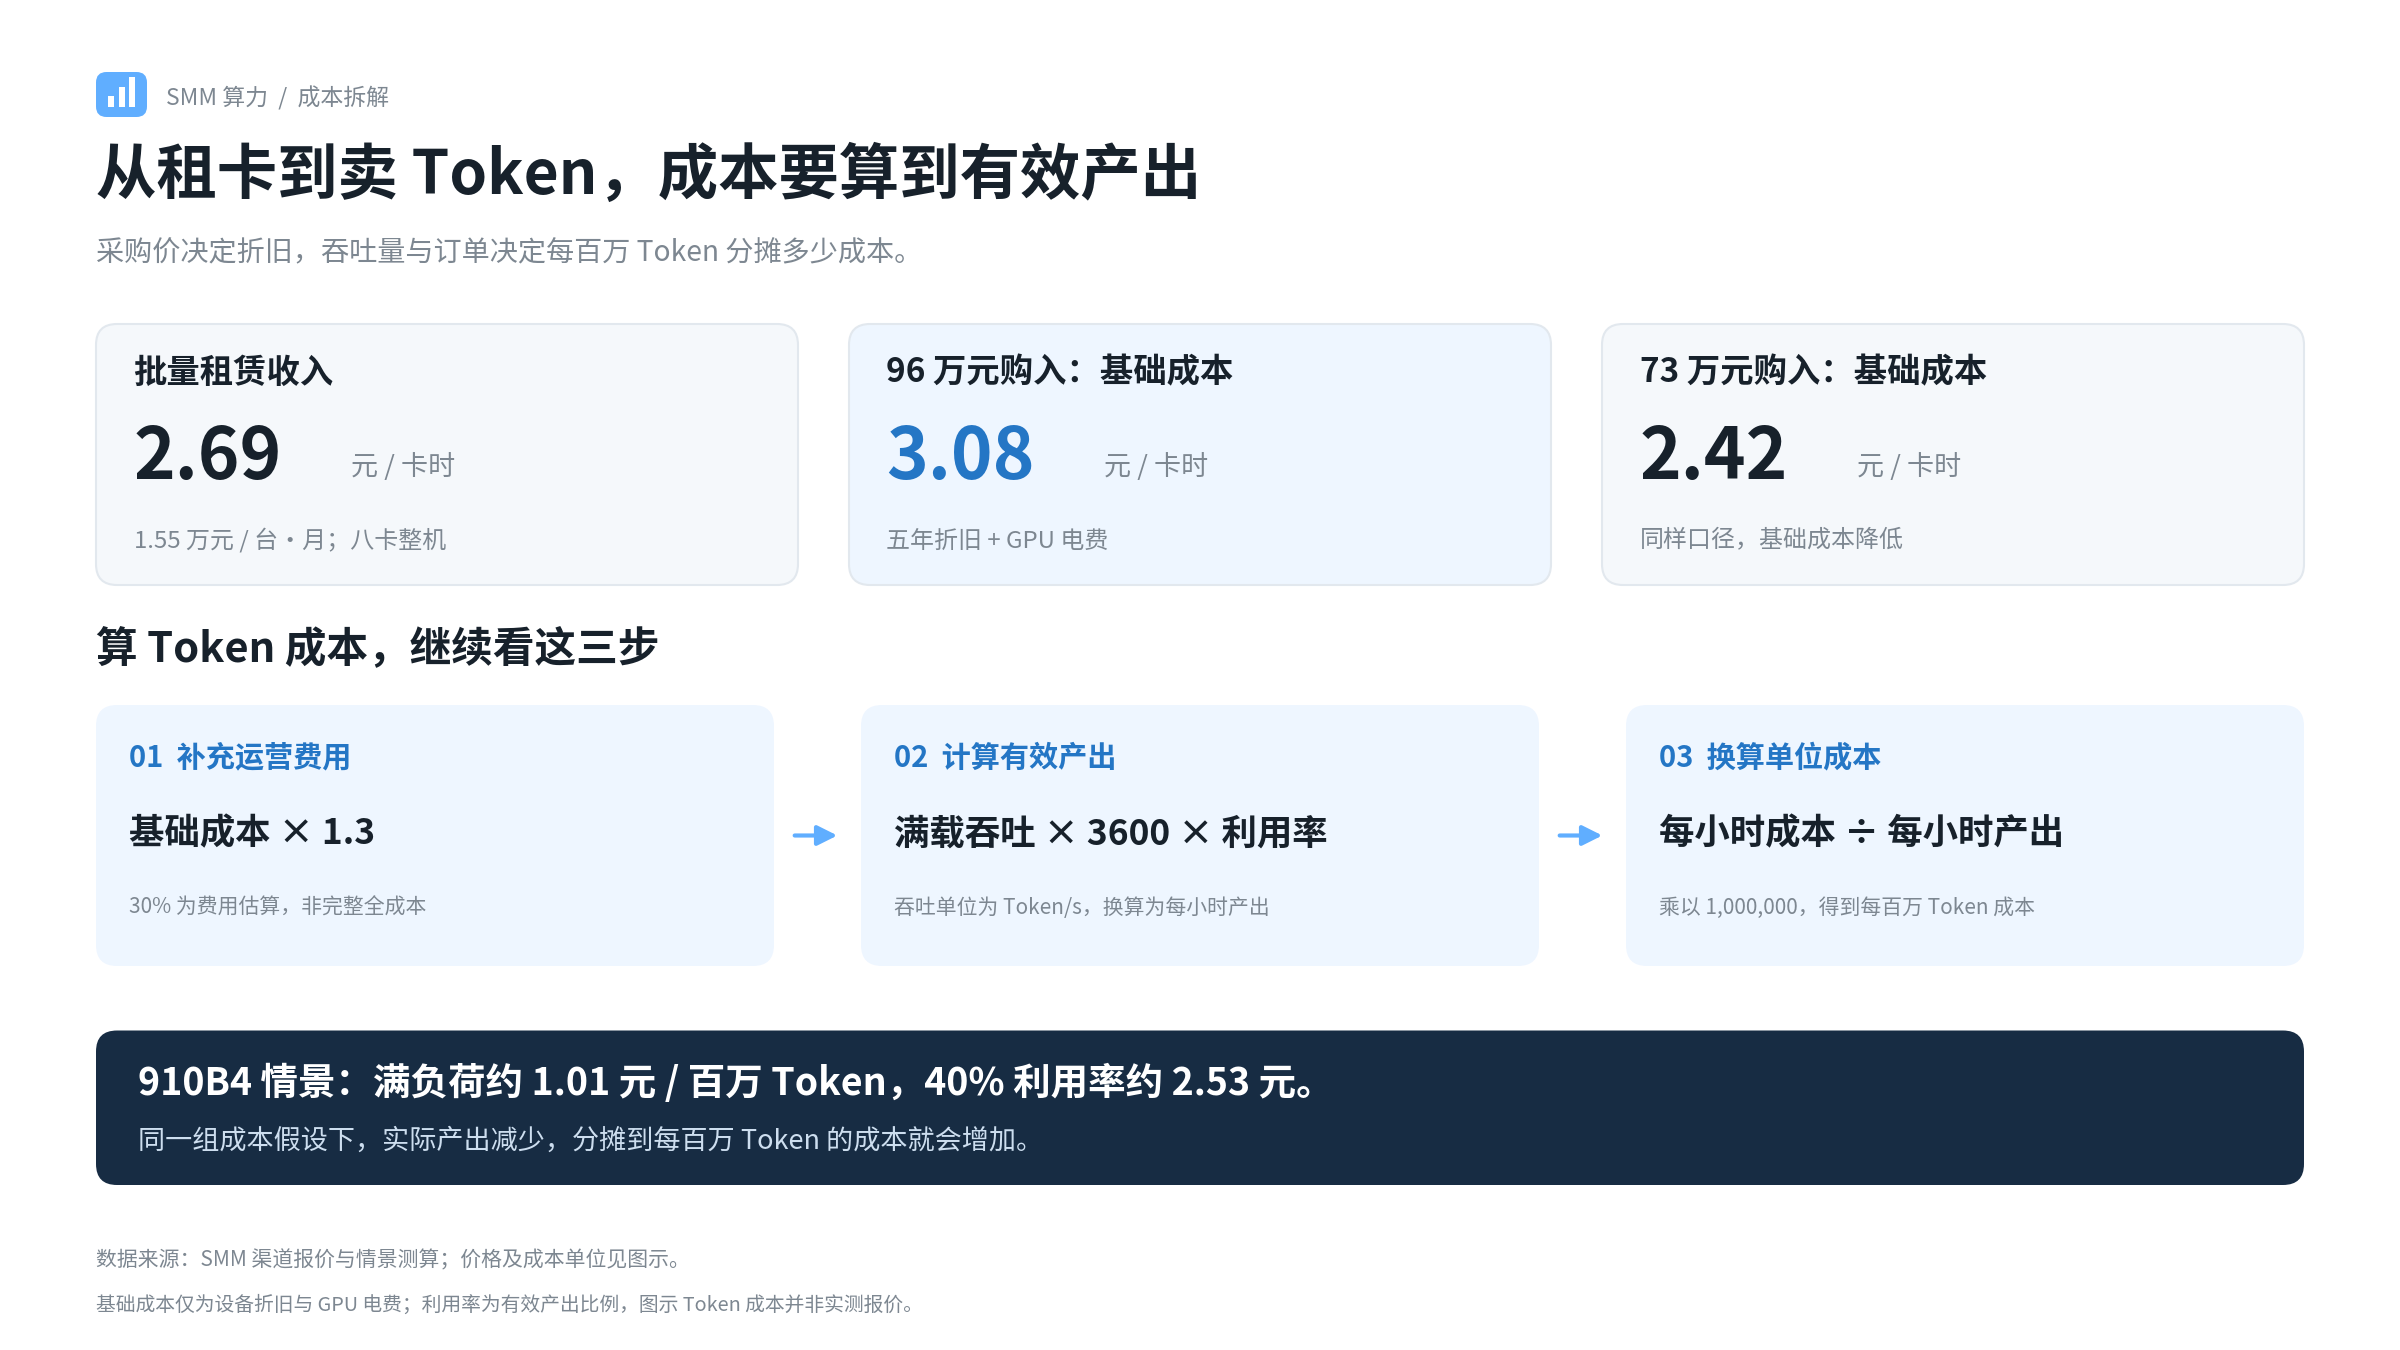
先算设备折旧和GPU电费。将96万元整机价格平均分摊到八张卡,每卡设备投入为12万元;按五年、每年8760小时折旧,每小时约2.74元。再按单卡功耗0.4kW、PUE为1.3、电价0.65元/度估算,电费约0.34元,合计约3.08元/卡时。
3.08元是这一简化口径下的基础成本,并未完整计入主机其他部件用电、机房、带宽、运维、资金和销售费用。
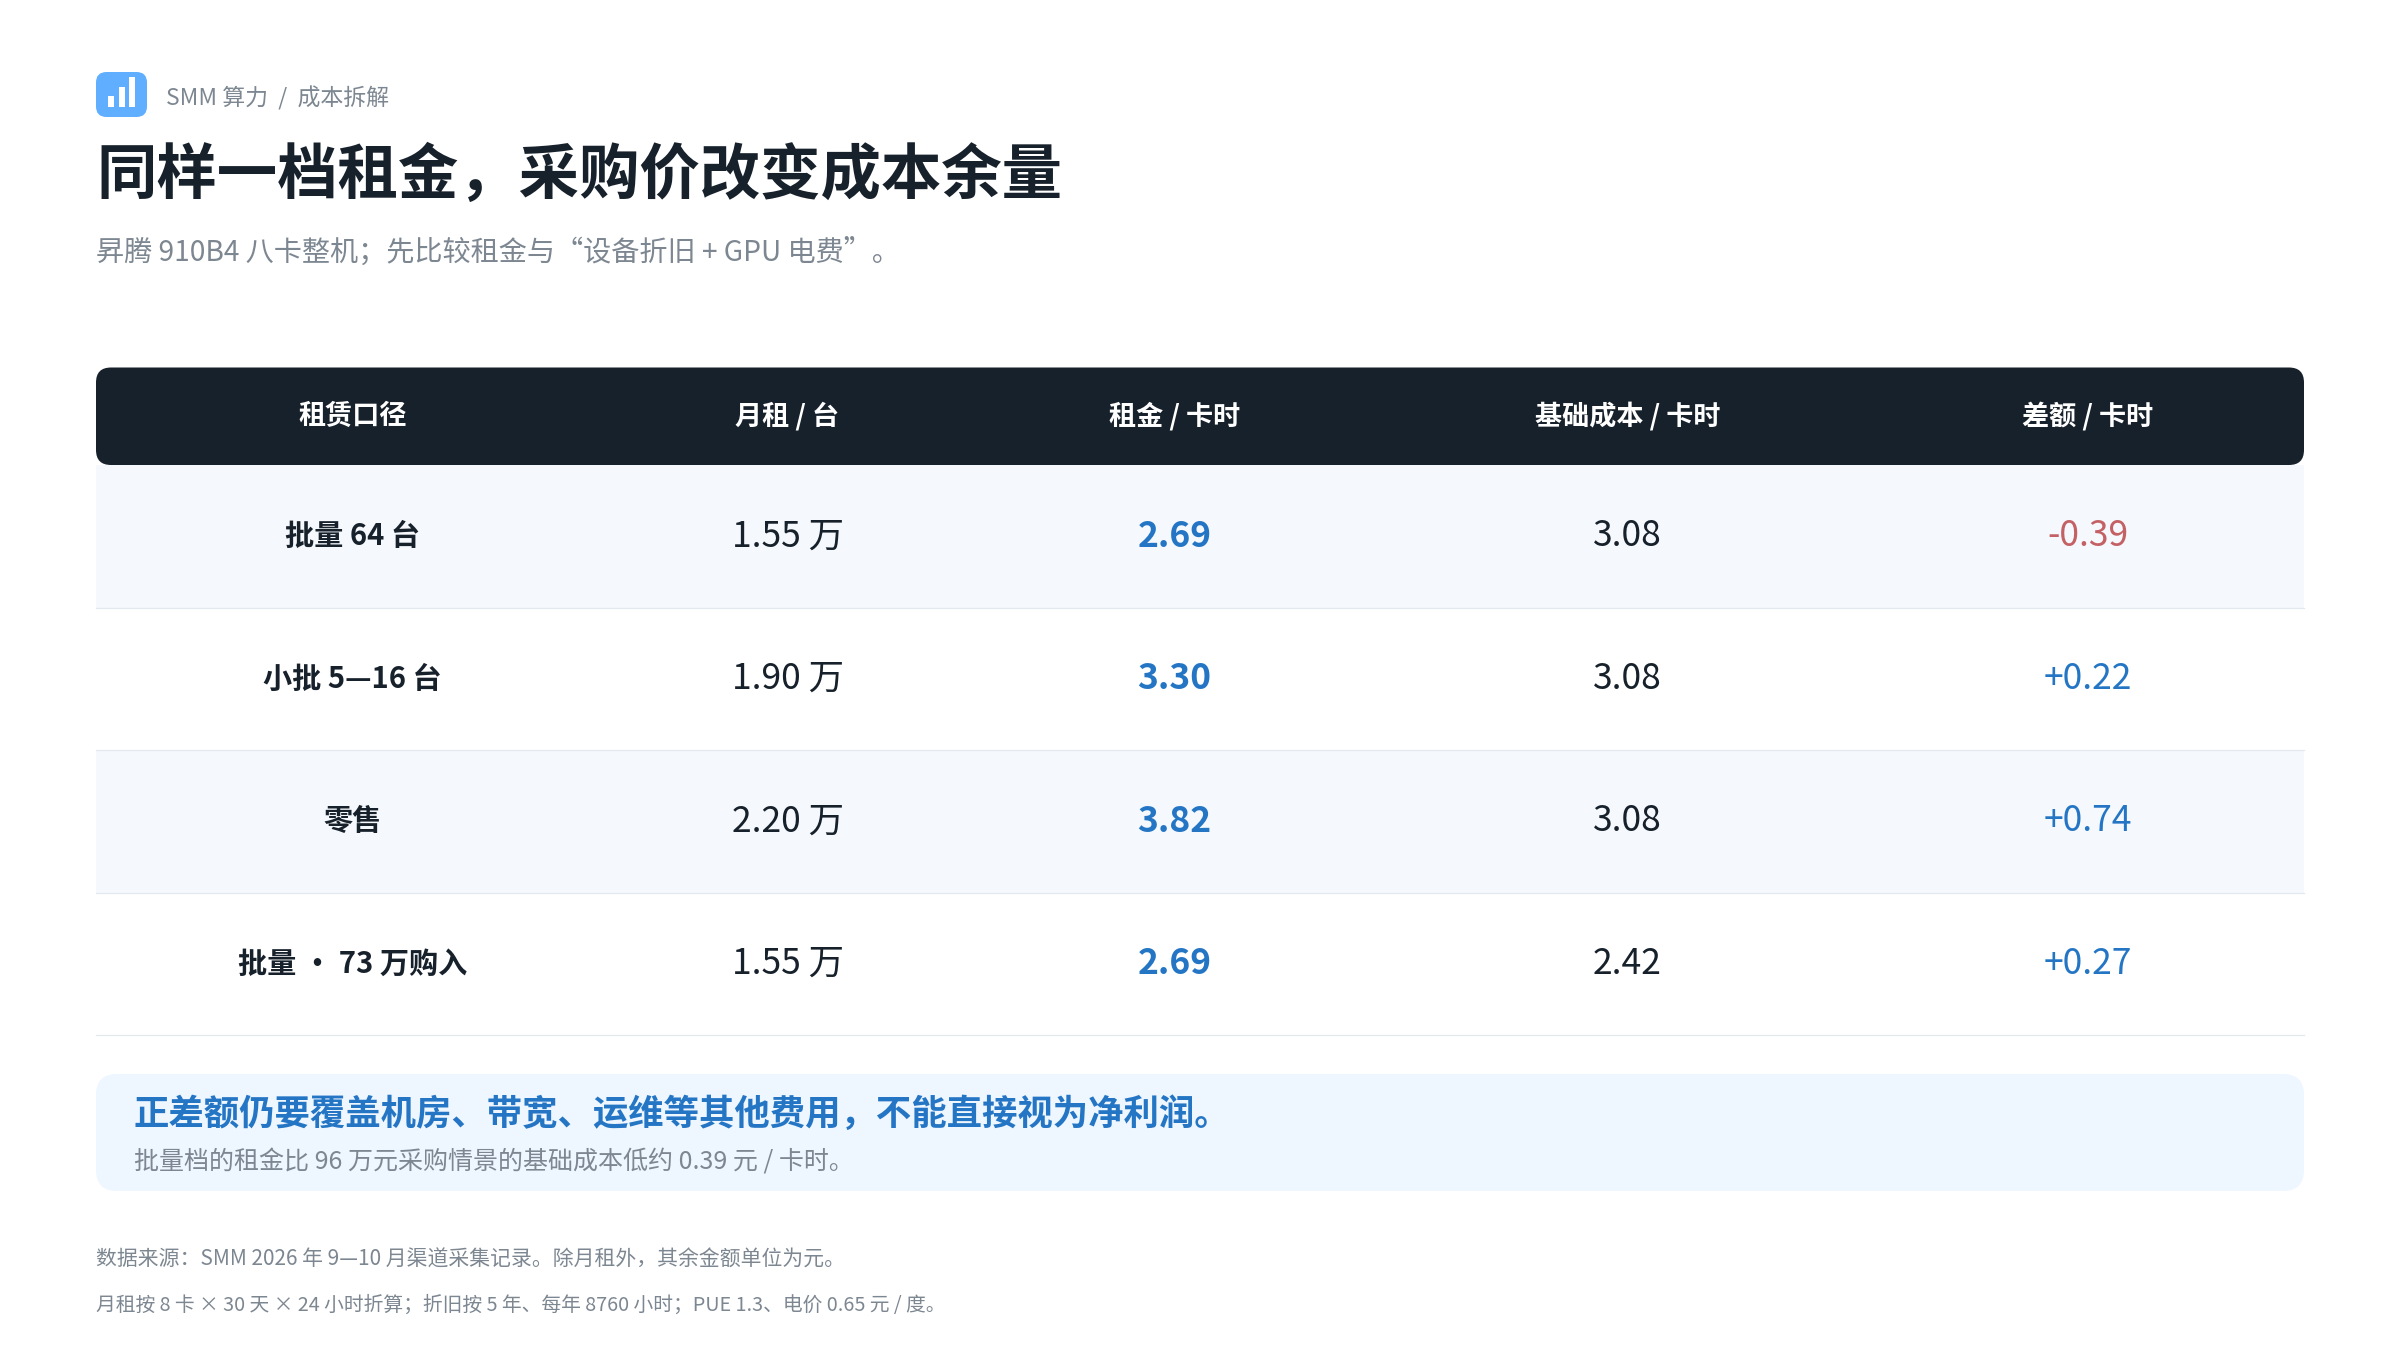
批量档2.69元的租金,比3.08元基础成本低约0.39元/卡时。即使全年租满,仅靠这档租金也难以覆盖上述成本。
采购价下调后,情况会变。渠道记录显示,10月有一批6月囤下的120台现货按73万元/台出清。以这一采购价测算,基础成本降至约2.42元/卡时;同样的批量租金,便能留下约0.27元/卡时,用于覆盖其他费用。
这还不能直接等同于盈利,但足以说明:看一台服务器能不能赚钱,先要问它是以什么价格买进来的。 单批次清仓,也不能据此推断整个国产卡租赁市场都在退出。
二、卖Token,换的是交付方式
租赁按占用设备的时间收费;模型服务通常按处理的输入、输出Token数量收费。Token可以理解为模型处理文本的计量单位,并不等于调用次数。一次调用可能只有几十个Token,也可能包含很长的上下文。
对客户来说,按量购买模型服务,省去了自行租卡、部署和维护的门槛。对运营方来说,来自不同客户的需求有机会被集中调度,提高设备的有效产出。但没有请求的闲置时间,仍然不会产生收入。
这一模式已有实际落地。中国移动发布的移动云(北京)Token中心,将昇腾、昆仑芯、摩尔线程等国产芯片资源与模型、计量和运营服务整合,通过统一接口向客户提供按需调用的能力。
从出租设备到交付模型服务,中间还要补齐模型适配、推理优化、调度和获客。若由第三方联合运营,分成也要计入账本。换一个收费方式,并不会自动增加利润。
三、从卡时成本,换算到每百万Token
换算的核心很简单:用同一段时间内的成本,除以同一段时间内的有效Token产出。
- 每百万Token成本 = 每卡每小时成本 × 1,000,000 ÷(满负荷吞吐量 × 3600 × 利用率)
沿用本文的简化模型,先计算设备折旧和GPU电费,再增加30%作为机房、带宽、存储及运维费用的估算。这里的“利用率”,指实际有效产出相对设定满负荷产出的比例,不等同于监控面板上的GPU利用率。
以910B4情景为例:若每卡满负荷吞吐量假设为1101 Token/s,基础成本按3.08元/卡时计,则每百万Token成本约为:
- 3.08 × 1.3 × 1,000,000 ÷(1101 × 3600)≈ 1.01元
为了便于比较,本文选用DeepSeek Flash空闲时段公开牌价作为价格参照:每百万输入Token为1元(缓存未命中),输出为4元。按输入与输出4∶1计算,每百万总Token对应1.60元,记为“10折”。因此,1.01元约相当于该参照价的6.3折。
吞吐量和价格必须对应同一种Token口径。 上面的计算要求吞吐量覆盖相同输入、输出比例下的总Token;若测试只给出输出Token/s,就不能直接与混合单价相比较。把DeepSeek牌价作为参照,也不意味着各卡运行的是同一个模型,或能提供相同的服务质量。
下表沿用研究模型的六组满负荷成本情景。它们基于采购价、电费及吞吐量假设,用于观察成本变化,并非六款卡在统一条件下的实测排名。其中按显存带宽线性外推吞吐量的做法较为粗略,实际部署仍需在目标模型、精度、并发和延迟要求下校准。
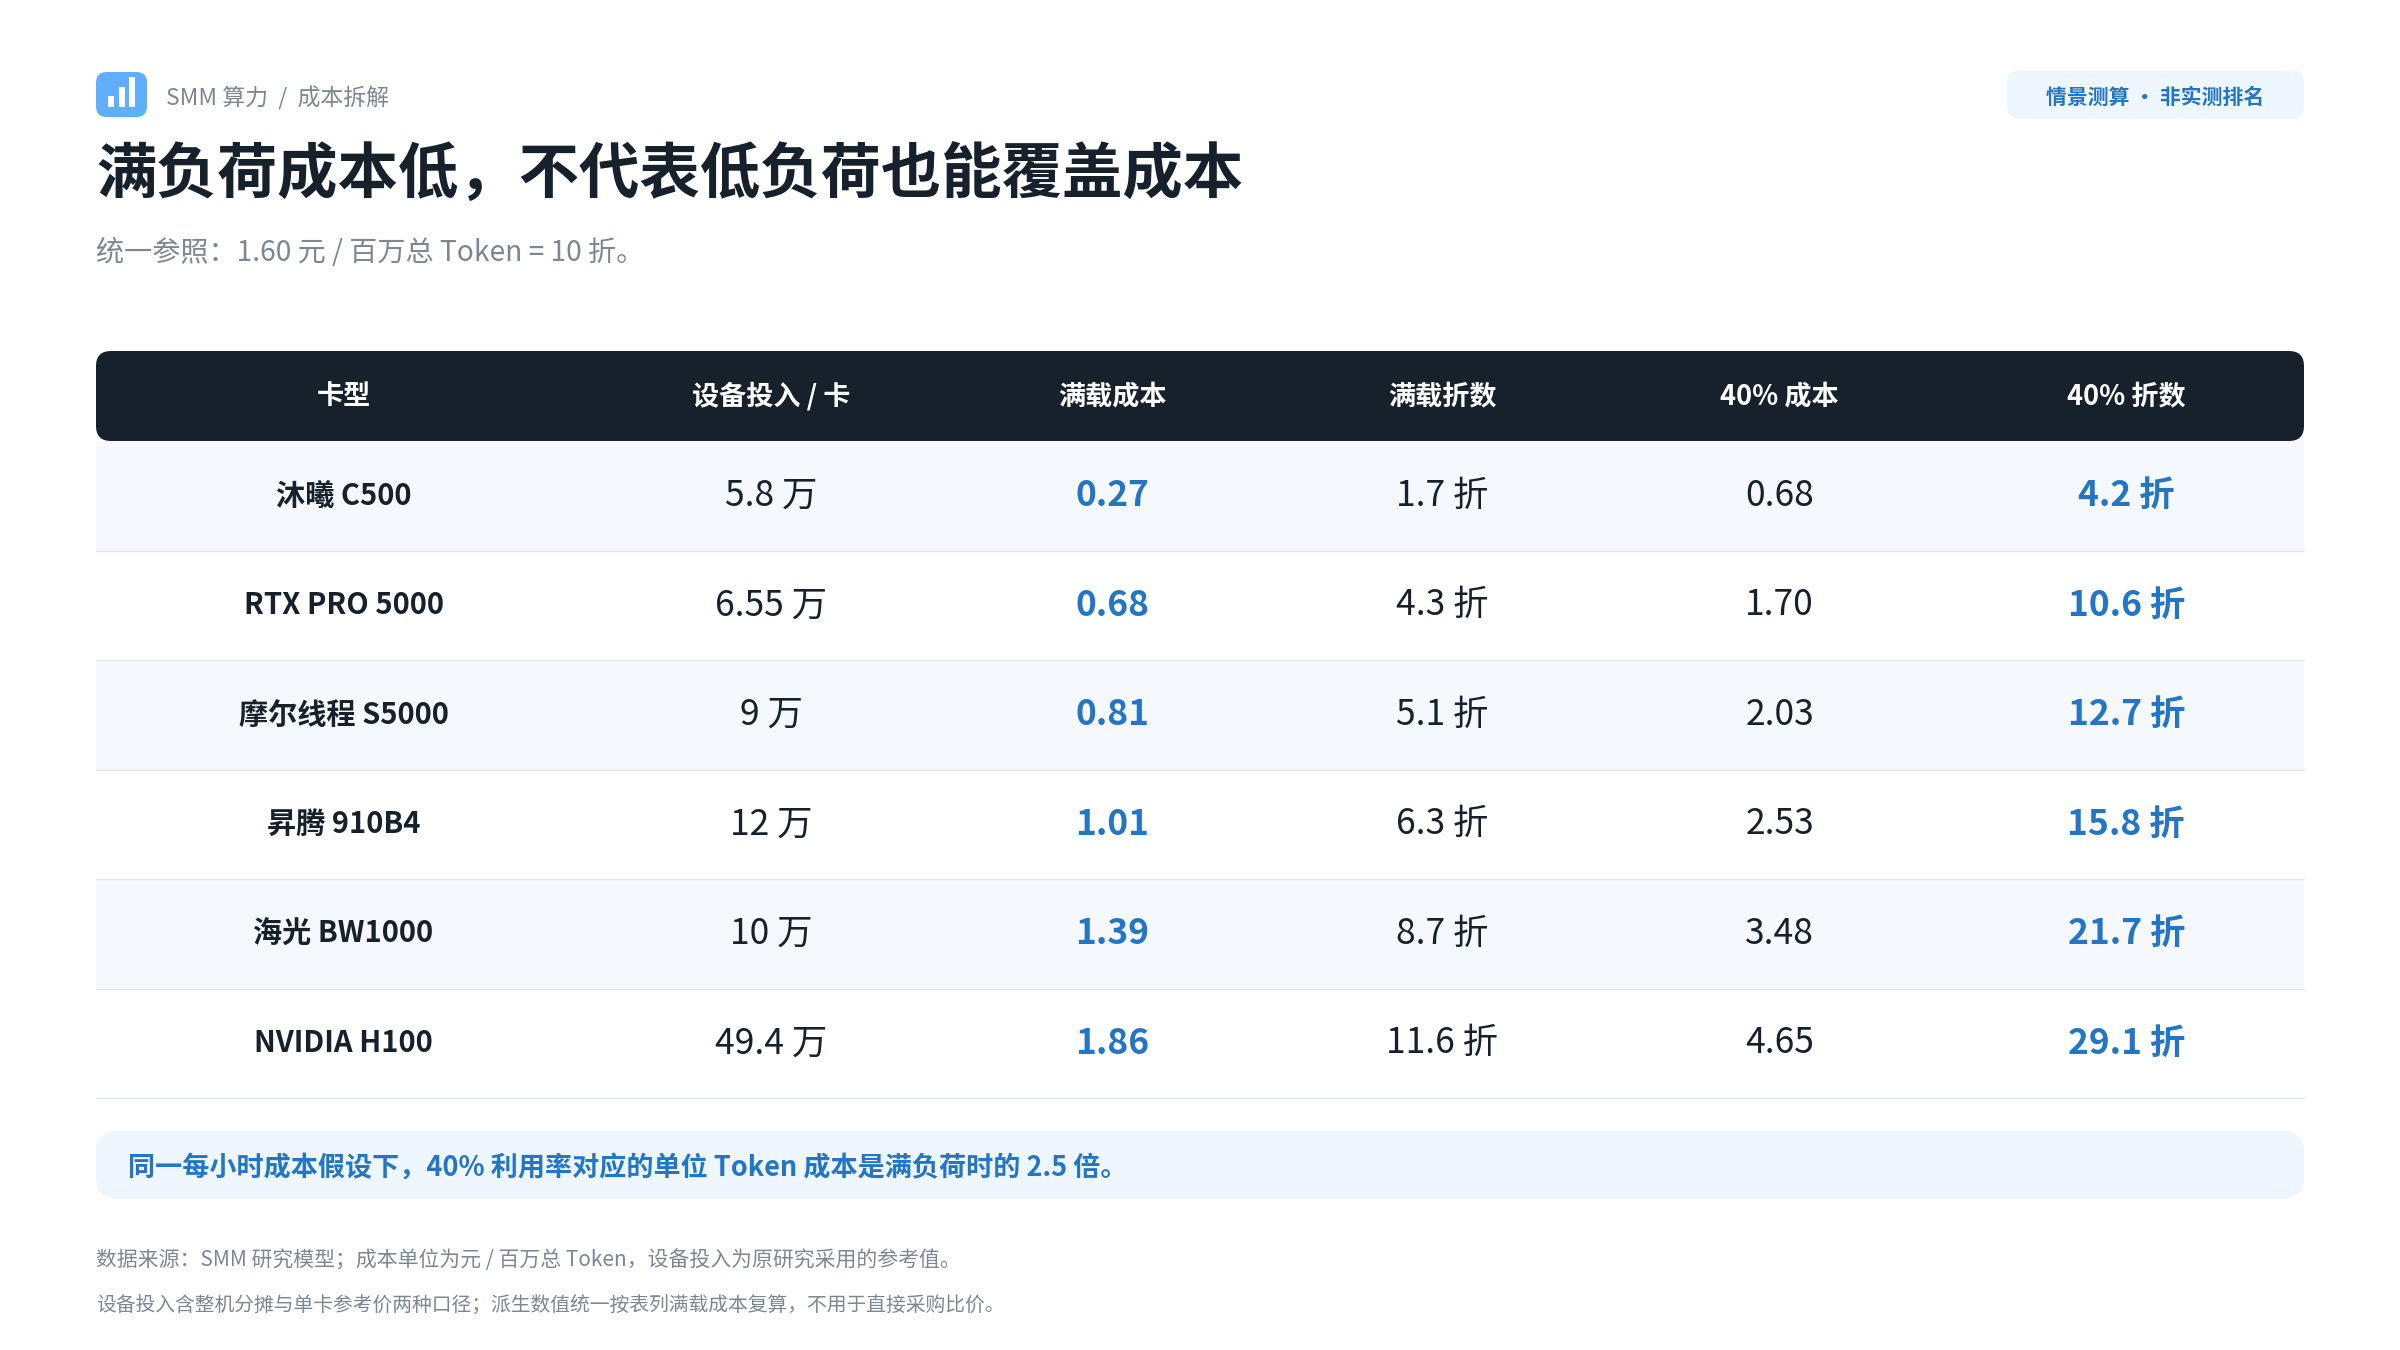
在这组假设下,四款国产卡的满负荷成本约为参照价的1.7—8.7折。但这个区间有一个关键前提:满负荷产出。
四、利用率一降,单位成本就上来
在每小时成本保持不变的简化模型中,利用率降到40%,每百万Token成本就变成满负荷时的2.5倍;降到20%,则变成5倍。
以910B4情景为例,满负荷成本约1.01元/百万Token;利用率降至40%时约2.53元,20%时约5.05元。换算为同一价格参照,分别约为6.3折、15.8折和31.6折。
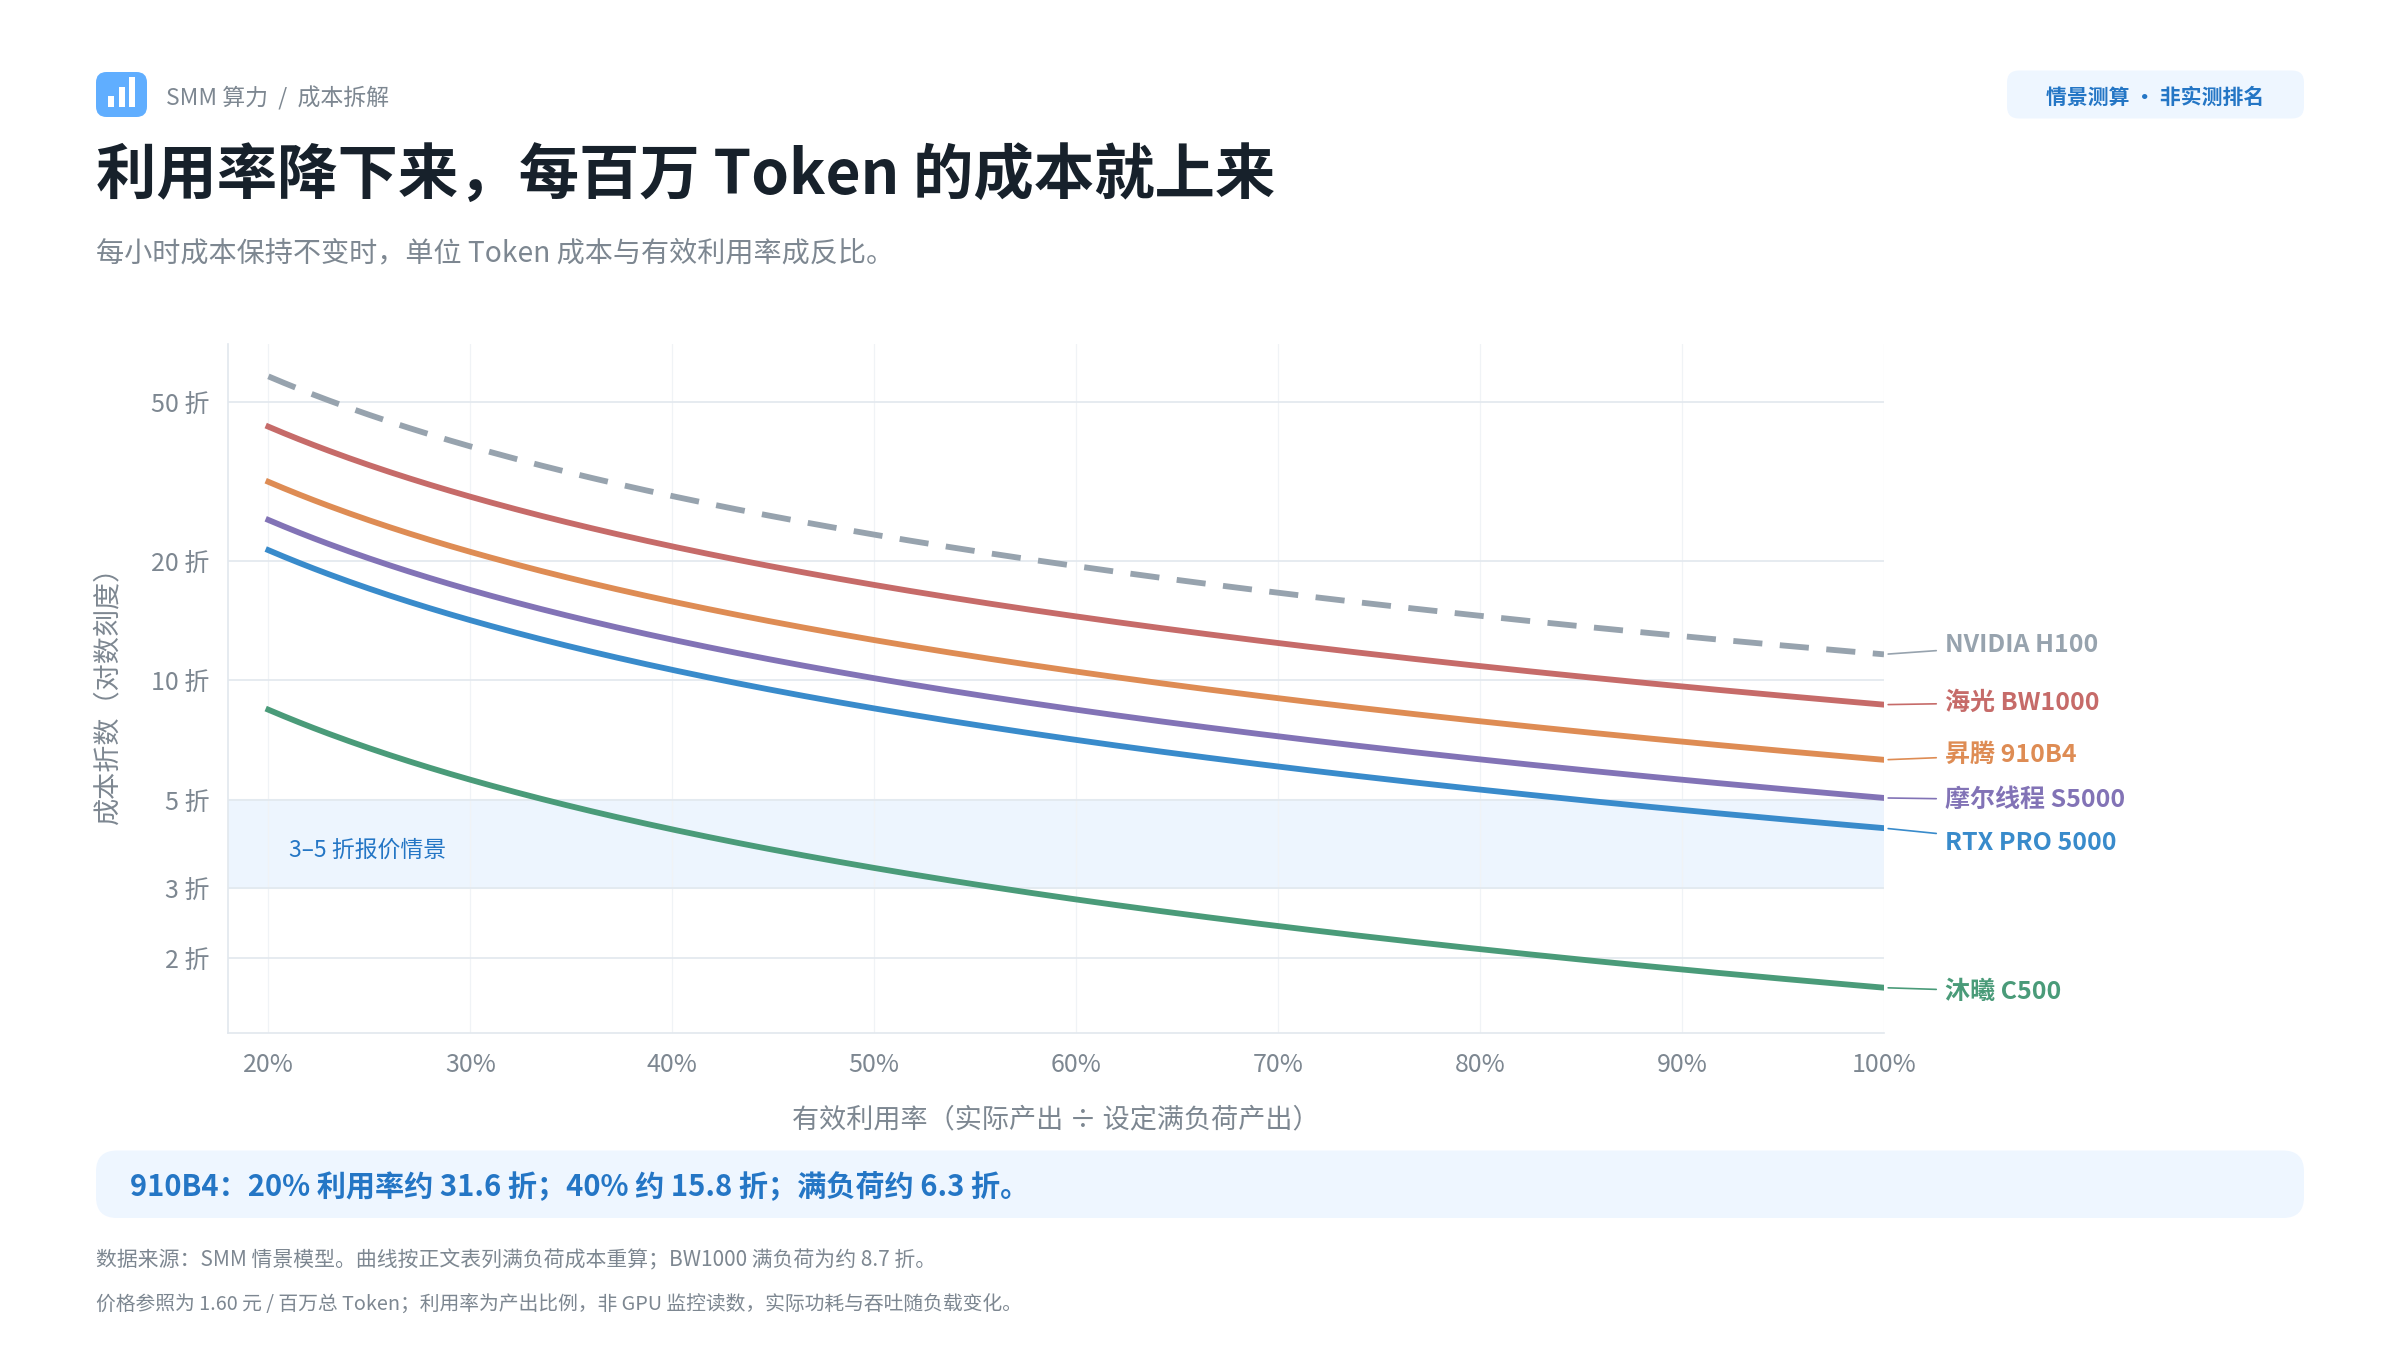
这也是“卡买得便宜”和“Token产得便宜”之间的距离。采购价降低了折旧压力,稳定的订单才能让这些成本被更多产出分摊。
这里展示的是敏感性分析,并非市场实际利用率调查。现实中,功耗会随负载变化,吞吐量也受批处理、缓存和软件优化影响,成本未必严格沿反比例曲线变化。
五、三折报价,留给成本多少空间?
按1.60元的统一参照,三折是0.48元/百万Token,五折是0.80元。本文将三至五折作为分销报价情景;不同模型、缓存规则、时段和服务等级下的折扣,不能直接混用。
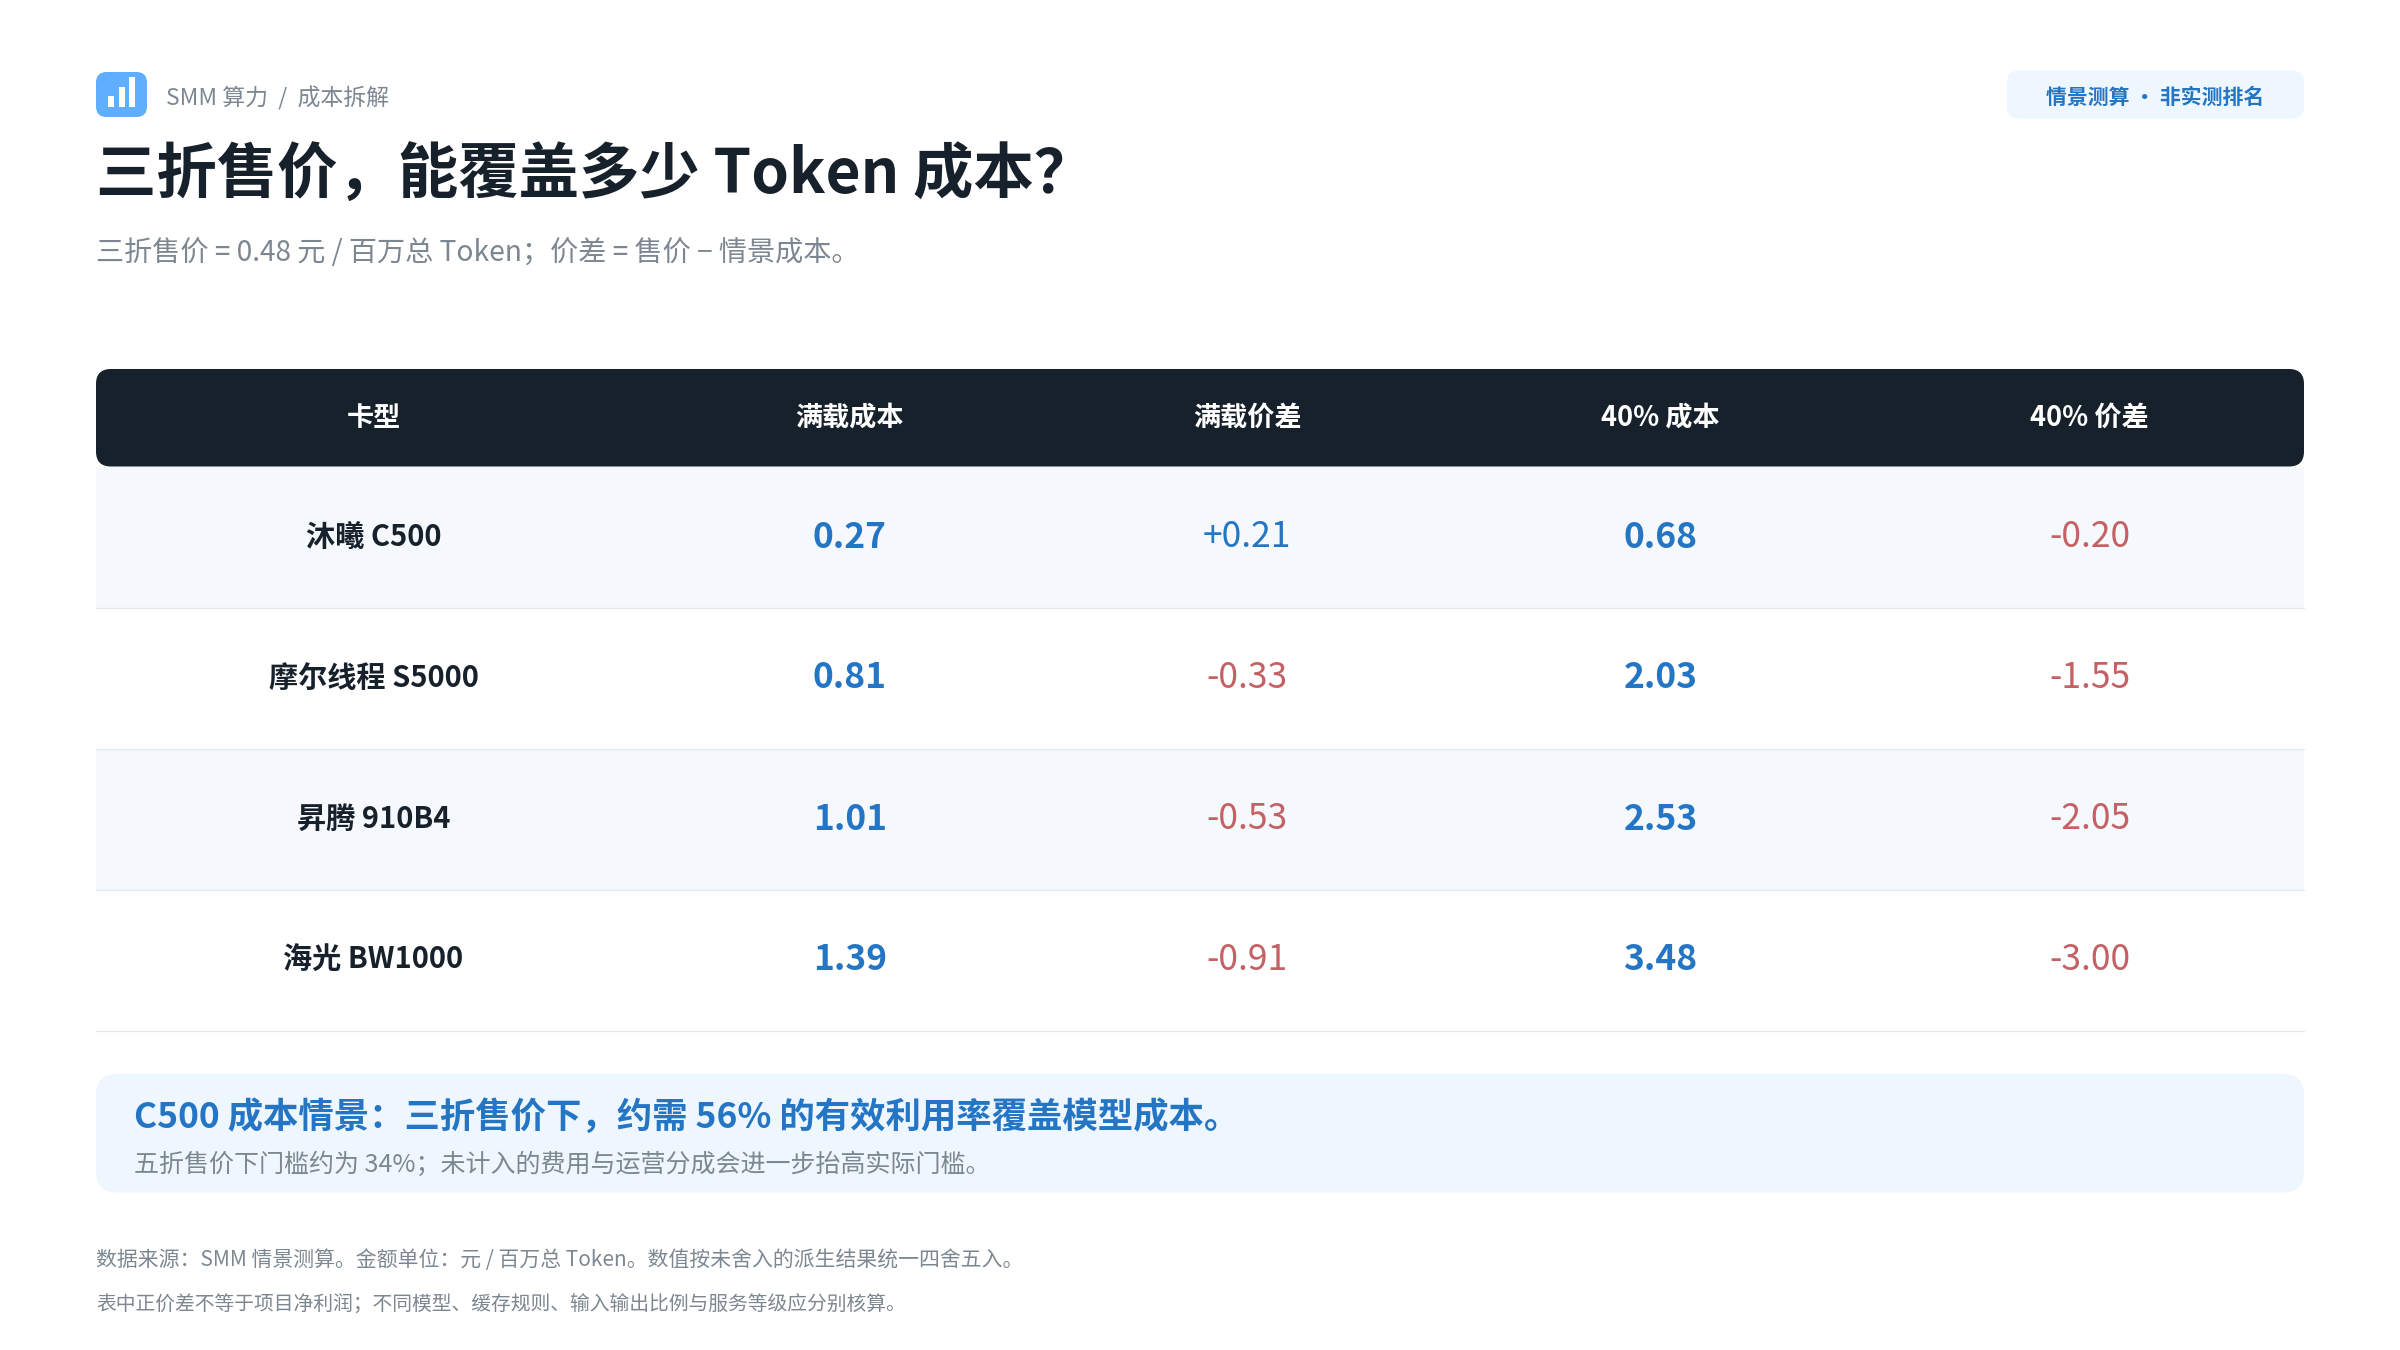
以C500成本情景为例,满负荷成本0.27元,三折售价0.48元,留下0.21元价差。若按“售价减成本,再除以售价”计算,测算毛利率约为43.8%。利用率降至40%后,成本约0.68元,便高于这一售价。
在其他条件不变时,该情景至少需要约56%的有效利用率,才能覆盖三折售价下的模型成本;若售价为五折,门槛约为34%。这些门槛仍未包含模型之外的费用,也不能直接当作实际项目的盈亏平衡点。
S5000和910B4情景的满负荷成本分别为0.81元、1.01元,已高于三折售价。单纯提高利用率无法填平这部分差额,还需要更低的采购成本、更高的有效吞吐量,或更高的销售价格。
因此,不能仅凭一个三折报价,就断言卖方一定亏损。双方可能采用了不同采购成本、模型、缓存方式、负载组合和运营安排。需要比较的是同口径的收入与成本。
六、最后要看的,是能卖出去的有效产出
显存带宽会影响推理表现,尤其是部分解码场景,但不能把它当作唯一变量。输入预处理、解码、批量大小、模型结构、量化方式和软件栈,都可能改变性能瓶颈。NVIDIA的技术分析也明确区分了预处理与解码的不同瓶颈,并指出推测解码等优化会改变计算与带宽的约束关系。[3]
同样,一张卡的估算成本与某家模型服务商的牌价接近,也不足以推断对方的真实成本或定价策略。
对算力持有方而言,判断是否适合转做Token服务,可以落到三件事上:设备以什么成本持有,目标业务每小时能产生多少有效Token,这些产出能以什么价格持续卖出去。
把卡搬进“Token工厂”,只是经营方式的变化。能否覆盖成本,要等采购、技术和订单三笔账合到一起,才有答案。